논문: DDG-DA: Data Distribution Generation for Predictable Concept Drift Adaptation
저자: Wendi Li, Xiao Yang, Weiqing Liu, Yingce Xia, Jiang Bian (UW–Madison, Microsoft Research Asia)
발표: AAAI 2022 (Thirty-Sixth AAAI Conference on Artificial Intelligence) · AAAI 원문 · arXiv · 코드(Qlib)
1. 들어가며
금융 시계열 모델은 어제까지의 데이터로 학습해서 내일을 예측함. 문제는 시장의 데이터 분포 자체가 계속 바뀐다는 점임. 이 현상을 개념 드리프트(concept drift)라고 부름.
기존 대응법은 대부분 "드리프트가 일어났는지 감지하고, 최신 데이터에 맞춰 모델을 다시 학습"하는 방식임. 이렇게 하면 모델은 항상 한 스텝 늦게 따라감. 이미 지나간 분포에 맞춰진 모델로 다음 기간을 예측하는 셈임.
DDG-DA는 발상을 뒤집음. 드리프트 중 상당수는 완전히 무작위가 아니라 계절성이나 반복되는 맥락을 따라 예측 가능한(predictable) 방향으로 움직인다는 관찰에서 출발함. 그렇다면 다음 기간의 데이터 분포를 미리 예측하고, 그 분포에 맞는 학습 데이터를 만들어 모델을 학습시키면 된다는 것이 핵심 아이디어임.
2. 왜 개념 드리프트는 금융 예측을 어렵게 만드는가
스트리밍 데이터는 시간 순서대로 들어오고, 메모리 제약 때문에 최근 $k$개 구간만 들고 있을 수 있음. 시점 $t$와 $t+1$ 사이에 결합 분포 $p_t(x, y)$가 바뀌면 그게 개념 드리프트임.
- 급변형 vs. 점진형: 정책 발표처럼 한순간 바뀌기도 하고, 시장 레짐처럼 서서히 바뀌기도 함
- 반복형 vs. 비반복형: 과거와 비슷한 국면이 다시 오기도 하고, 처음 보는 국면이 오기도 함
- 예측 가능한 드리프트: 계절성·반복되는 맥락을 따라 방향을 어느 정도 가늠할 수 있는 경우. 이 논문의 타깃임
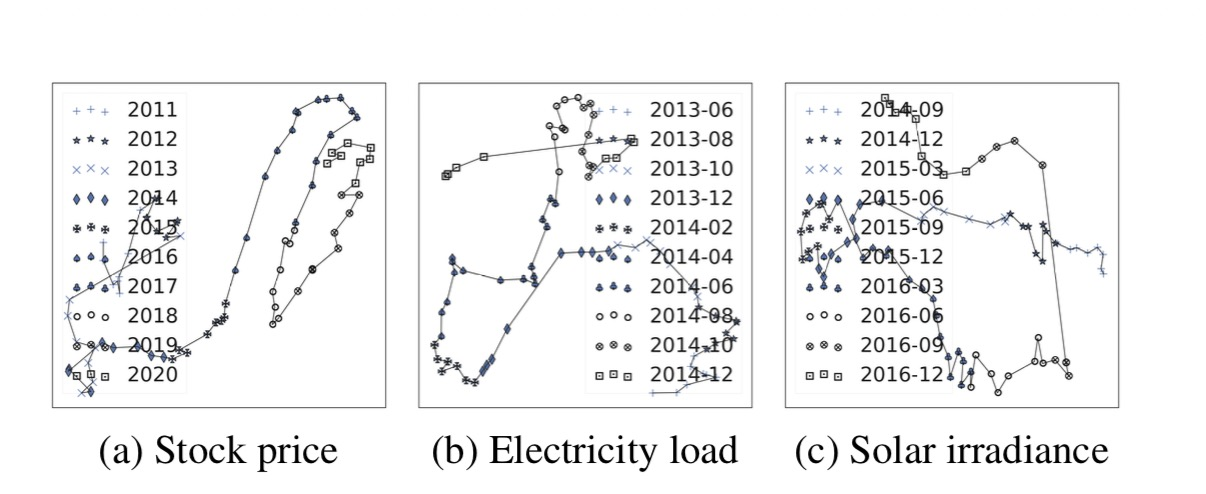
주식 데이터는 이 문제가 특히 심함. 논문 Figure 2는 주가·전력 수요·일사량 데이터의 분포가 시간에 따라 이동하는 모습을 시각화했는데, 대부분 무작위가 아닌 추세를 가진 이동을 보임. 이 관찰이 "분포를 예측할 수 있다"는 주장의 근거가 됨.
3. 선행 연구와 이 논문의 기여
기존 드리프트 적응 연구는 크게 두 갈래로 나뉨.
- 망각(forgetting) 기반: GF-Lin, GF-Exp처럼 오래된 샘플일수록 가중치를 선형·지수적으로 줄임. "최근 데이터가 미래와 가장 비슷하다"는 가정에 기대고 있음
- 앙상블·적응형 트리: ARF(Adaptive Random Forest), Condor처럼 드리프트를 감지해 트리를 교체하거나 과거 모델을 재사용함. 대신 특정 모델 구조에 묶여 있어 model-agnostic하지 않음
두 갈래 모두 드리프트가 "일어난 뒤" 반응함. 드리프트의 미래 추세를 직접 모델링한 연구는 거의 없었음. 저자들이 내세운 기여는 세 가지임.
- 예측 가능한 드리프트를 다음 시점의 데이터 분포를 생성하는 방식으로 다룬 처음의 방법
- 학습을 가능하게 하는 미분 가능한 분포 거리를 제안하고, 이것이 KL divergence와 동치임을 이론적으로 보임
- 주가·전력 수요·일사량 예측에서 기존 SOTA 적응 기법보다 나은 성능을 보임. 모델에 독립적이라 LightGBM부터 GRU까지 어떤 예측 모델에도 붙일 수 있음
4. 미래 데이터 분포는 어떻게 예측하고 학습하는가
4.1 문제 설정: 태스크 단위의 롤링 예측
매 시점 $t$마다 하나의 태스크(task)가 있음. 태스크는 학습 집합 $D^{(t)}_{train}$와 테스트 집합 $D^{(t)}_{test}$로 구성되고, 둘의 분포는 다를 수 있음(non-i.i.d.). 목표는 앞으로 올 여러 테스트 구간의 손실을 최소화하도록 예측 모델을 매번 적응시키는 것임.
$$
\min_{f^{(t)},\dots,f^{(t+\tau)}} \sum_{i=t}^{t+\tau} \ell\big(f^{(i)}(x^{(i)}),, y^{(i)}\big)
$$
- $f^{(i)}$: 시점 $i$에 쓰는 예측 모델 (예: LightGBM)
- $\ell$: 예측 손실, $\tau$: 적응을 반복하는 미래 구간 길이
4.2 리샘플러: 과거 데이터에 가중치를 주는 방법
DDG-DA는 미래 데이터를 새로 만들지 않음. 대신 과거 학습 샘플을 어떤 확률로 다시 뽑을지(resampling)를 학습해서, 다음 기간 분포와 비슷한 학습 집합을 구성함.
$$
q^{(t)}_{train} = M_\Theta\big(g(D^{(t)}{train})\big)
$$
- $g$: 규칙 기반 피처 추출기. 각 샘플 구간과 최근 테스트 구간 사이의 유사도(KL 기반)를 피처로 만듦
- $M_\Theta$: 이 피처를 받아 각 샘플의 리샘플링 확률을 출력하는 모델 (학습 대상 파라미터 $\Theta$)
- $q^{(t)}_{train}$: 리샘플링 확률. 이로부터 만든 $D^{(t)}{resam}(\Theta)$가 곧 예측한 분포 $p^{(t)}_{resam}(x, y; \Theta)$임
4.3 손실 함수: KL divergence가 제곱오차가 되는 이유
이상적인 목표는 실제 테스트 분포와 예측 분포 사이의 KL divergence를 줄이는 것임. $p(x)$ 항이 비슷하다고 보고 조건부 분포만 비교하면 다음과 같음.
$$
\mathcal{L}_\Theta(task^{(t)}) = \mathbb{E}_{x\sim p^{(t)}_{test}(x)}\Big[D_{KL}\big(p^{(t)}_{test}(y\mid x),|,p^{(t)}_{resam}(y\mid x;\Theta)\big)\Big]
$$
$p(y|x)$가 분산이 일정한 가우시안이라고 가정하면, 두 가우시안 사이의 KL은 평균 차이의 제곱 $(\mu_1 - \mu_2)^2$에 비례함(논문 Theorem 1). 따라서 손실은 상수배를 빼면 단순한 제곱오차가 됨.
$$
\mathcal{L}_\Theta(task^{(t)}) = \frac{1}{2}\sum_{(x,y)\in D^{(t)}_{test}} \big(\hat{y}^{(t)}_{resam}(x;\Theta) - y\big)^2
$$
- $\hat{y}^{(t)}_{resam}(x; \Theta)$: 리샘플링한 데이터로 학습한 모델이 테스트 샘플 $x$에 내는 예측값
- 즉 "리샘플링이 잘 됐는가"를 "그 데이터로 학습한 모델이 미래를 잘 맞히는가"로 평가하는 셈임
4.4 Proxy 모델과 bi-level 최적화
문제는 $\hat{y}_{resam}$을 얻으려면 매번 모델을 학습해야 하고, 그 과정을 통과해 $\Theta$에 대한 기울기를 구해야 한다는 점임. LightGBM 같은 트리 모델은 미분이 안 됨. 그래서 저자들은 학습 단계에서만 선형 proxy 모델 $\hat{y}_{proxy}(x; \phi) = x\phi$를 사용함. 리샘플링 확률을 가중치로 한 가중최소제곱은 닫힌해가 있음.
$$
\phi^{(t)} = \big(X^{(t)\top} Q^{(t)} X^{(t)}\big)^{-1} X^{(t)\top} Q^{(t)} y^{(t)}
$$
- $X^{(t)}, y^{(t)}$: 시점 $t$ 태스크의 학습 피처와 레이블
- $Q^{(t)}$: 리샘플링 확률을 대각 원소로 갖는 행렬
닫힌해라서 $\phi^{(t)}$가 $\Theta$의 미분 가능한 함수가 됨. 내부 문제($\phi$ 학습)의 해를 외부 문제(테스트 손실)에 대입하는 bi-level 최적화를 일반 경사하강법으로 풀 수 있음.
$$
\Theta^* = \arg\min_\Theta \sum_{task^{(t)}\in Task_{train}} \mathcal{L}_\Theta\big(task^{(t)}\big)
$$
핵심은 가중치 학습은 선형 proxy로, 실제 예측은 아무 모델로 한다는 분리임. 학습된 리샘플러가 만든 데이터셋을 LightGBM이든 GRU든 그대로 학습시키면 됨.
5. 롤링 재학습에서는 어떻게 쓰이는가
5.1 DDG-DA가 들어간 롤링 파이프라인
DDG-DA는 예측 모델을 바꾸는 게 아니라 롤링 재학습에 넣을 데이터를 바꾸는 모듈임. 전체 흐름은 다음과 같음.
- 과거 구간을 여러 학습용 태스크로 자르고, 4장의 bi-level 목적함수로 리샘플러 $M_\Theta$를 학습함
- 새 재학습 시점이 오면, 메모리 구간의 과거 데이터에 피처 추출기 $g$를 적용하고 $M_\Theta$로 샘플별 리샘플링 확률을 구함
- 그 확률로 만든 데이터셋(= 예측한 다음 기간 분포)으로 실제 예측 모델(LightGBM 등)을 학습함
- 다음 구간을 예측한 뒤 시점을 한 칸 옮겨 2~3을 반복함
드리프트 감지기는 따로 없음. 매 재학습마다 "다음 분포에 맞는 가중치"가 자동으로 주어지는 구조임.
5.2 비교 대상 방법
① RR (Rolling Retraining): 메모리 구간 데이터를 동일 가중치로 다시 학습하는 가장 기본적인 방식임.
② GF-Lin / GF-Exp (Gradual Forgetting): RR과 같지만 오래된 샘플의 가중치를 각각 선형·지수적으로 줄임.
③ ARF (Adaptive Random Forest): 드리프트 감지기를 달고 트리를 교체하는 적응형 랜덤포레스트임. 모델 구조에 묶여 있음.
④ Condor: 과거 모델을 재사용하는 앙상블임. 모델에 독립적이지 않고 분류 문제에만 쓸 수 있음.
①②는 DDG-DA처럼 어떤 예측 모델에도 붙일 수 있어서, 8.2절의 "모델별 일반화" 실험에서도 비교 대상으로 쓰임.
6. 백테스트는 어떻게 설계했는가
주가 시나리오는 예측 정확도뿐 아니라 실제 포트폴리오 성과까지 평가함. Microsoft Qlib 위에서 다음과 같이 설계함.
- 신호 평가: 모델 예측값과 실제 수익률 사이의 IC(Information Coefficient), 그리고 IC의 안정성을 보는 ICIR을 계산함
- 전략: 예측 점수 상위 종목을 사고 하위 종목을 파는 buy-winners / sell-losers 방식으로 50개 종목 포트폴리오를 운용함
- 비용: 거래비용 2‰(0.2%)를 반영함
- 벤치마크: CSI500 지수
- 포트폴리오 지표: 연율화 수익률(Ann.Ret.), 샤프 비율, 최대낙폭(MDD)
재학습은 월 단위(20 거래일마다 새 태스크)로 함. 더 짧은 간격이 성능에는 유리하지만 비용 때문에 이 정도로 두었고, 부록 D.1에서 간격을 줄일수록 효과가 있지만 체감 효과가 줄어든다고 보고함.
7. 데이터와 실험 세팅
세 가지 실제 스트리밍 예측 과제에서 실험함. 금융 외 데이터를 넣은 건 방법이 도메인에 독립적임을 보이기 위함임.
| 시나리오 | 데이터 | 메모리(학습 구간) | 테스트 구간 | 평가 지표 |
|---|---|---|---|---|
| 주가 추세 | 중국 A주 약 4,000종목, 일별, 2009–2020, 팩터 약 300개 | 2년 | 2016–2020 (학습 태스크 2011–2015) | IC, ICIR, Ann.Ret., Sharpe, MDD |
| 전력 수요 | UCI, 사용자 370명, 15분 단위, 2011–2015 | 1년 | 2013–2015 | NMAE, NRMSE |
| 일사량 | Pedro et al., 5분 단위, 2014–2016 | 1년 | 2015–2016 | MAE, RMSE, Skill |
- 기본 예측 모델: 검증 데이터에서 가장 좋았던 LightGBM
- 재학습 간격: 주가 20 거래일, 전력·일사량 7일
- Skill: "직전 값이 그대로 유지된다"는 persistence 예측 대비 개선율
- NMAE·NRMSE: 타깃의 평균 절대값으로 정규화한 오차
8. 결과는 어떻게 나왔는가
8.1 드리프트 적응 기법과의 비교 (LightGBM 기준, Table 1)
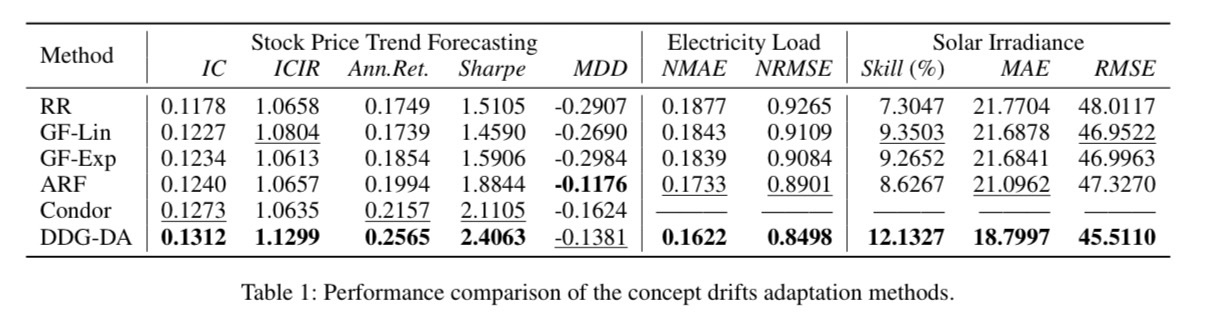
세 시나리오 모두에서 DDG-DA가 대부분의 지표를 가장 좋게 만듦.
- 주가: IC 0.1312로 RR(0.1178)과 최고 베이스라인 Condor(0.1273)를 넘음. ICIR 1.1299, 연율화 수익률 25.65%, 샤프 2.4063
- 주가 MDD는 예외: DDG-DA는 −13.81%로, ARF(−11.76%)보다 낙폭이 컸음
- 전력 수요: NMAE 0.1622, NRMSE 0.8498로 가장 낮음
- 일사량: Skill 12.13%, MAE 18.80, RMSE 45.51로 가장 좋음
실행 시간은 RR·GF와 비슷한 수준이고, ARF가 훨씬 느렸음(Table 5). 리샘플러 학습이 닫힌해 기반이라 추가 비용이 작은 것으로 보임.
8.2 예측 모델을 바꿔도 통하는가 (Table 2·3)
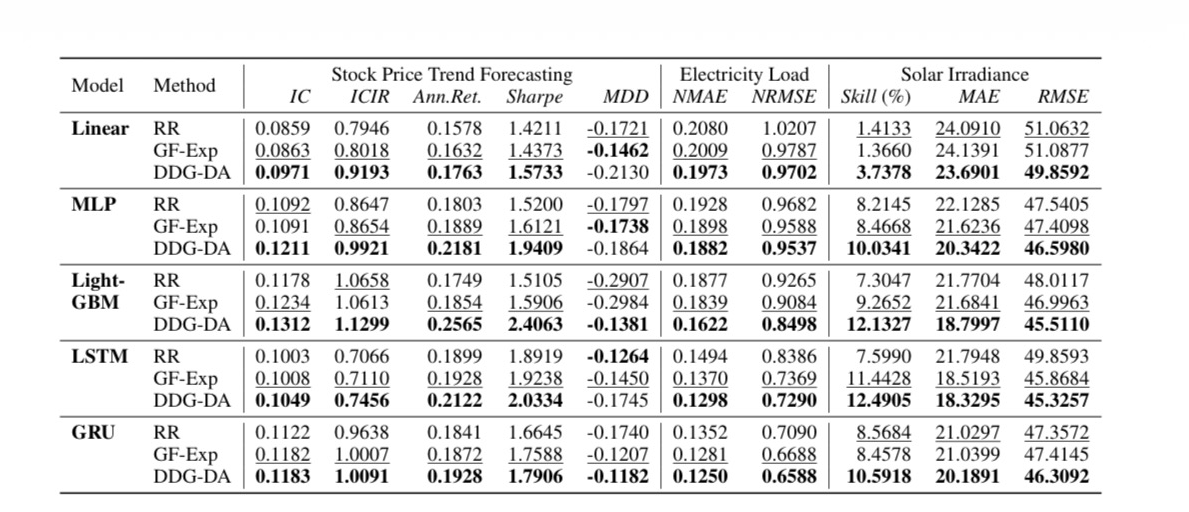
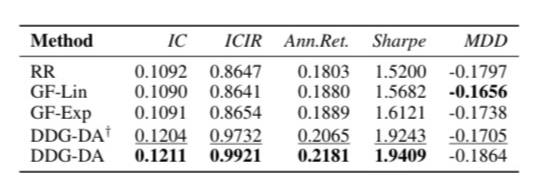
Linear, MLP, LightGBM, CatBoost, LSTM, GRU, ALSTM의 7개 모델에 붙여 RR·GF-Exp와 비교했고, 대부분의 조합에서 DDG-DA가 우세했음.
- MLP의 주가 IC가 0.1092(RR)에서 0.1211로 오름
- LSTM의 일사량 Skill이 7.60%에서 12.49%로 오름
- 선형 proxy 대신 MLP proxy와 경사 기반 하이퍼파라미터 최적화(GHO)를 쓴 DDG-DA†는 RR·GF는 이기지만 닫힌해 버전보다 약간 낮았음(IC 0.1204 vs. 0.1211). 언롤링 스텝 수 $k$에 민감한 것도 단점임
즉 GBDT든 시퀀스 딥러닝이든 모델을 가리지 않고 데이터 단에서 성능을 올릴 수 있음. 가중치 학습은 선형 proxy로 충분하다는 점도 확인됨.
8.3 케이스 스터디와 한계
부록 D.3에서는 학습된 리샘플링 가중치가 시장 상황에 따라 달라지는 모습을 보여줌. 어떤 태스크에서는 비슷한 하락 추세를 가진 과거 샘플의 가중치를 키웠음. 그 결과 2017년 RR·GF-Lin·GF-Exp가 겪은 낙폭을 DDG-DA는 피했음(Figure 8).
한계도 분명함.
- 예측 불가능한 드리프트에는 약함: 무작위 급변을 넣은 합성 데이터에서는 성능이 불안정함(부록 D.2)
- 정적 모델 가정: 드리프트 패턴 자체는 학습 태스크와 테스트 태스크 사이에 바뀌지 않는다고 가정함. 저자들은 동적 버전을 향후 과제로 남김
- 가우시안 가정: KL을 제곱오차로 바꾸는 과정은 $p(y|x)$가 분산이 일정한 가우시안이라는 가정에 기대므로, 꼬리가 두꺼운 수익률 분포에서는 근사일 뿐임

