[2026-2] 정유림 - Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data?
논문 정보
- Title: Why do tree-based models still outperform deep learning on typical tabular data?
- 인용수: 261122기준, 5,026회
- Authors: Léo Grinsztajn, Edouard Oyallon, Gaël Varoquaux
- Conference: NeurIPS 2022 (Datasets and Benchmarks Track)
- Paper: https://arxiv.org/abs/2207.08815
- Code: https://github.com/LeoGrin/tabular-benchmark
1. Introduction
딥러닝은 이미지와 자연어 처리 분야에서 기존 머신러닝 알고리즘을 크게 능가하는 성능을 보여왔다. 하지만 **Tabular data(정형 데이터)**에서는 여전히 XGBoost, Random Forest 등의 Tree-based model이 강력한 성능을 보인다.
그렇다면 왜 딥러닝은 Tabular data에서 항상 우수한 성능을 보이지 못할까?
이 논문은 이러한 현상을 단순한 모델 성능 비교가 아닌, Tree-based model과 Neural Network가 가지는 Inductive bias의 차이에서 설명하려고 한다.
Inductive bias는 모델이 데이터를 학습할 때 구조적으로 선호하거나 가정하는 패턴을 의미한다.
예를 들어 CNN은 이미지에서 인접한 픽셀 사이의 공간적 관계를 활용하도록 설계되어 있다. 반면 일반적인 Tabular data에서는 각 feature가 서로 다른 의미와 통계적 특성을 가지기 때문에 이러한 구조적 가정을 정의하기 어렵다.
저자들은 Tree-based model이 Tabular data에서 좋은 성능을 보이는 이유를 세 가지 가설로 정리한다.
- Neural Network는 uninformative feature에 상대적으로 민감하다.
- Neural Network는 지나치게 smooth한 함수를 학습하는 경향이 있다.
- Tabular data에서는 feature의 원래 좌표축을 보존하는 것이 중요하다.
이를 검증하기 위해 다양한 Tabular dataset에서 모델의 성능을 비교하고, 입력 데이터와 target function을 인위적으로 변형하여 성능이 어떻게 달라지는지 분석했다.
2. Experimental Setup
2.1 Datasets
저자들은 OpenML 등을 통해 수집한 45개 Tabular dataset을 사용했다.
모든 데이터를 포함하는 대신, 다음과 같은 기준으로 일반적인 Tabular learning 문제에 적합한 데이터셋을 선정했다.
조건설명
| Dataset size | 최소 3,000개 sample |
| Feature dimension | 500개 미만 |
| Feature/sample ratio | d/n < 0.1 |
| Feature type | 서로 다른 의미를 가진 heterogeneous features |
| Missing values | 결측값 제거 |
| Classification | Balanced binary classification |
| Training samples | 주요 실험에서 최대 10,000개 |
이러한 조건으로 인해 본 연구는 주로 중간 규모의 Tabular data에 초점을 맞춘다.
2.2 Compared Models
Tree-based model과 Neural Network를 다음과 같이 비교했다.
Tree-based modelsNeural Networks
| Tree-based models | Neural Networks |
| XGBoost | MLP |
| Gradient Boosting Trees | ResNet |
| Random Forest | FT-Transformer |
| HistGradientBoosting Trees | SAINT |
엄밀히 말하면 Random Forest는 boosting 계열이 아니므로, 논문의 비교 대상은 GBDT뿐 아니라 더 넓은 Tree-based model이다.
특히 FT-Transformer와 SAINT는 Tabular data를 위해 제안된 딥러닝 모델이므로, 단순한 MLP뿐 아니라 Tabular-specific architecture까지 비교했다는 점이 중요하다.
2.3 Hyperparameter Optimization
모델마다 약 400회의 Random Search를 수행했다.
각 탐색 예산에서 Validation set 기준으로 가장 좋은 hyperparameter를 선택한 뒤, Test set에서 성능을 평가했다.
또한 Random Search 순서를 15번 섞어 탐색 과정에 따른 성능 변동을 함께 확인했다.
평가에는 Classification의 Accuracy, Regression의 R²를 사용했으며, 데이터셋별 난이도가 다르다는 점을 고려해 성능을 정규화하여 집계했다.
이러한 설정을 통해 단순히 Neural Network의 hyperparameter tuning이 부족해서 GBDT가 우수하게 나타나는 것인지를 검증할 수 있었다.
3. Benchmark Results: Tree-based Models Outperform Deep Learning
Figure 1 — Performance across hyperparameter search budgets
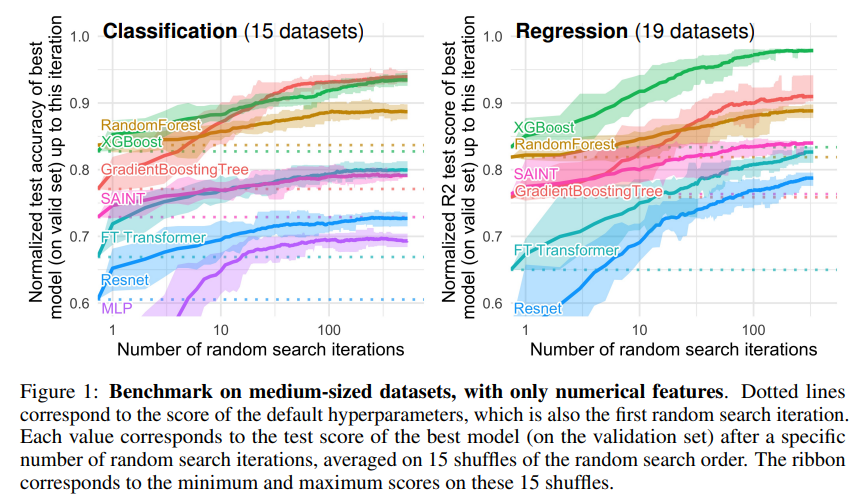
첫 번째 실험에서는 Hyperparameter Search 횟수에 따라 모델별 성능이 어떻게 달라지는지 비교했다.
주요 결과는 다음과 같다.
- Tree-based model은 적은 탐색 예산에서도 높은 성능을 보였다.
- Hyperparameter Search 횟수가 증가해도 Tree-based model의 성능 우위가 유지되었다.
- Numerical feature만 사용하는 경우에도 GBDT와 Neural Network 사이의 성능 차이가 상당 부분 유지되었다.
즉, Tree-based model의 우위는 단순히 hyperparameter tuning이나 categorical feature 처리 문제로 설명되지 않았다.
저자들은 이러한 차이가 각 알고리즘의 Inductive bias와 관련되어 있을 것으로 가정하고, 후속 실험을 진행했다.
4. Finding 1: Neural Networks Are Biased Toward Overly Smooth Solutions
Figure 2 — Smoothing the target function
첫 번째 발견은 Neural Network가 지나치게 smooth한 함수를 선호한다는 것이다.
4.1 Smooth vs. Irregular Function
Smooth function은 입력값이 조금 변할 때 출력값도 점진적으로 변하는 함수다.
반면 Irregular function은 특정 지점에서 출력값이 급격하게 변화하거나 복잡한 국소 패턴을 가진다.
예를 들어 하나의 feature에 대해 다음과 같은 조건을 생각할 수 있다.
- x < 5이면 y = 0
- x ≥ 5이면 y = 1
Decision Tree는 x ≥ 5라는 분할 조건만으로 이 관계를 직접 표현할 수 있다.
반면 일반적인 Neural Network는 학습 과정에서 상대적으로 매끄러운 함수를 우선 학습하는 경향이 있다.
이는 Neural Network가 높은 표현력을 가지고 있더라도, 모든 형태의 함수를 동일한 난이도로 학습하지는 않는다는 것을 의미한다.
4.2 Experiment
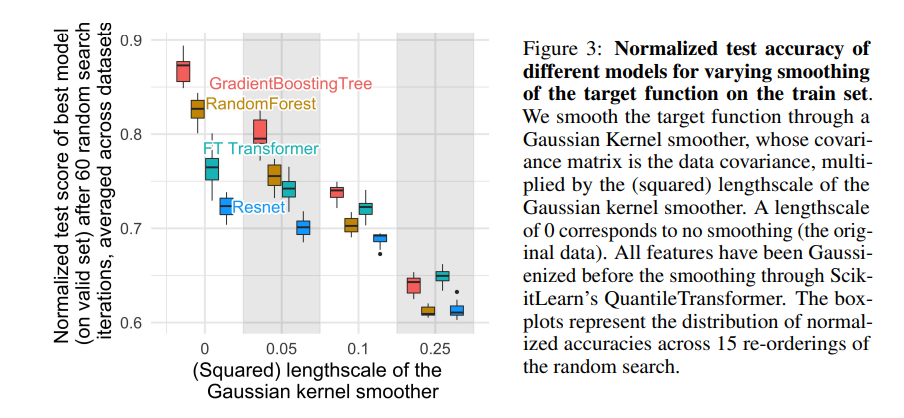
저자들은 Gaussian Kernel Smoothing을 이용해 Training set의 Target function을 점차 매끄럽게 변형했다.
이때 Test set의 원래 평가 대상은 유지했다.
따라서 모델이 원래 데이터에 존재하는 불규칙한 패턴을 얼마나 활용하는지 확인할 수 있다.
Smoothing의 강도는 Gaussian kernel의 length-scale을 조절하여 변화시켰다.
4.3 Results
Figure 2에서는 다음과 같은 결과가 나타났다.
- Smoothing을 적용하지 않은 원래 데이터에서 Tree-based model이 높은 성능을 보였다.
- 약한 Smoothing을 적용하자 Tree-based model의 성능이 크게 감소했다.
- 반면 Neural Network의 성능은 초기 Smoothing에 상대적으로 덜 민감했다.
- Smoothing을 더욱 강하게 적용하면 전반적인 모델 성능이 감소했다.
이는 원래 Tabular dataset의 Target function에 불규칙한 패턴이 존재하며, Tree-based model이 이를 효과적으로 학습하고 있을 가능성을 보여준다.
Interpretation
Neural Network는 비교적 smooth한 함수를 학습하려는 경향이 있는 반면, Tree-based model은 piecewise constant function을 사용하기 때문에 급격한 변화나 불연속적인 관계를 자연스럽게 표현할 수 있다.
단, Neural Network가 irregular function을 표현할 수 없다는 뜻은 아니다. 적절한 architecture, optimization, regularization을 통해 이러한 패턴을 학습할 가능성은 충분히 있다.
5. Finding 2: Neural Networks Are More Sensitive to Uninformative Features
Figures 3–4 — Removing and adding uninformative features
두 번째 발견은 Neural Network, 특히 MLP 계열 모델이 예측에 불필요한 feature에 상대적으로 민감하다는 것이다.
5.1 Why Are Uninformative Features Important?
실제 Tabular data에서는 모든 feature가 예측에 도움이 되는 것은 아니다.
일부 feature는 target과 관련된 정보를 제공하지만, 다른 feature는 예측에 거의 기여하지 않거나 중복된 정보를 포함한다.
Tree-based model은 각 노드에서 예측 성능을 개선하는 분할 조건을 선택한다.
따라서 유용한 feature에 기반한 분할을 반복하면서 불필요한 feature의 영향을 상대적으로 적게 받을 수 있다.
반면 일반적인 MLP는 여러 feature를 Linear layer에서 혼합하기 때문에 어떤 feature가 중요한지를 학습 과정에서 찾아야 한다.
5.2 Experiment 1: Removing Features
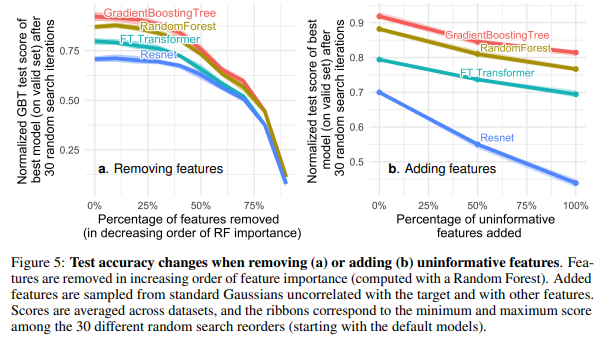
먼저 Random Forest를 이용해 Feature importance를 계산했다.
이후 중요도가 낮은 feature부터 점진적으로 제거하면서 모델 성능의 변화를 분석했다.
Figure 3에서는 중요도가 낮은 feature의 상당 부분을 제거하더라도 GBT의 성능이 크게 감소하지 않는 현상이 관찰되었다.
또한 제거된 feature만 사용했을 때는 예측 성능이 상대적으로 낮았다.
이는 전체 feature 중 상당수가 예측 성능에 큰 기여를 하지 않을 수 있다는 것을 보여준다.
5.3 Experiment 2: Adding Random Features
다음으로 실제 입력 데이터에 Target과 무관한 Gaussian random features를 추가했다.
이때 추가한 feature는 기존 feature 및 target과 독립적이므로 새로운 예측 정보를 제공하지 않는다.
Figure 4b의 결과는 다음과 같다.
- Random feature가 증가할수록 전체 모델의 성능이 감소했다.
- ResNet은 성능이 상대적으로 빠르게 감소했다.
- GBT와 Random Forest는 더 작은 성능 감소를 보였다.
- FT-Transformer 역시 ResNet보다 상대적으로 강건한 결과를 보였다.
반대로 중요도가 낮은 feature를 제거한 Figure 4a에서는 ResNet과 다른 모델 사이의 성능 차이가 줄어들었다.
5.4 Interpretation
이 결과는 Tabular data에서 좋은 성능을 얻기 위해서는 단순히 복잡한 feature interaction을 학습하는 능력뿐 아니라, 불필요한 feature를 효과적으로 무시하는 능력이 중요하다는 것을 보여준다.
특히 모든 Neural Network가 동일하게 민감했던 것은 아니라는 점이 중요하다.
FT-Transformer는 ResNet보다 불필요한 feature에 강건한 경향을 보였으며, 이는 architecture의 차이가 feature selection과 관련된 Inductive bias에 영향을 줄 수 있음을 시사한다.
6. Finding 3: Preserving Feature Orientation Is Important
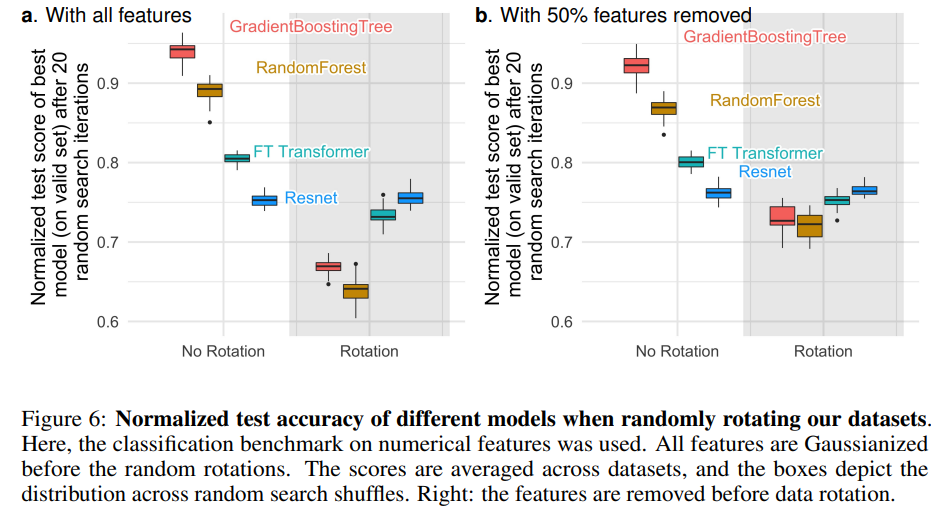
Figure 5 — Random rotation of input features
세 번째 발견은 Tabular data에서 각 feature의 원래 좌표축이 중요할 수 있다는 것이다.
6.1 Rotation Invariance
Rotation invariance는 데이터를 직교 회전시켜 좌표계를 바꾸더라도 학습 알고리즘의 동작이나 성능이 유지되는 성질을 의미한다.
예를 들어 두 개의 feature로 구성된 데이터를 생각해 보자.
- x₁: Age
- x₂: Weight
원래 데이터에서는 각각의 feature가 명확한 의미를 가진다.
하지만 Random rotation을 적용하면 새로운 feature는 Age와 Weight의 선형결합으로 구성된다.
이때 데이터에 포함된 정보 자체는 손실되지 않더라도, 각 feature가 가지던 개별적인 의미와 좌표축은 달라지게 된다.
Decision Tree는 일반적으로 하나의 feature를 기준으로 데이터를 분할하는 Axis-aligned split을 사용한다.
따라서 원래 좌표계에서 단순하게 표현되던 분할 경계가 회전 이후에는 복잡해질 수 있다.
반면 일반적인 MLP는 이론적으로 선형 변환을 첫 번째 layer에 흡수할 수 있으므로, 좌표계 회전에 상대적으로 영향을 적게 받을 수 있다.
6.2 Experiment
저자들은 입력 feature를 Gaussianization한 뒤 Random Orthogonal Rotation을 적용했다.
회전 변환은 Training set과 Test set에 동일하게 적용했다.
이후 원본 데이터와 회전된 데이터에서 각 모델의 성능을 비교했다.
6.3 Results
Figure 5a에서 가장 흥미로운 결과는 다음과 같다.
- Random rotation 이후 Tree-based model의 성능이 크게 감소했다.
- FT-Transformer 역시 성능이 감소했다.
- ResNet은 상대적으로 안정적인 성능을 유지했다.
- 결과적으로 모델 간 성능 순위가 역전되어 Neural Network가 Tree-based model보다 높은 성능을 보였다.
Figure 5b에서는 중요도가 낮은 feature의 50%를 제거한 뒤 같은 실험을 수행했다.
그 결과 Random rotation에 의한 성능 감소가 완화되었다.
6.4 Interpretation
이 결과는 Tabular data의 개별 feature 축에 모델 학습에 유용한 구조적 정보가 존재할 수 있다는 것을 시사한다.
Tree-based model은 이러한 원래의 feature orientation을 효과적으로 활용하지만, 일반적인 MLP는 좌표축에 대한 선호가 상대적으로 약하다.
저자들은 이를 두 번째 발견인 Uninformative feature 문제와도 연결한다.
입력 feature가 무작위로 혼합되면 중요한 feature와 불필요한 feature를 구분하기 어려워질 수 있다.
따라서 Tabular data에서는 모든 좌표 변환에 동일하게 반응하는 것보다, 원래 feature의 구조를 활용하는 학습 방식이 유리할 수 있다.
다만 이는 일반적인 Linear transformation이나 PCA가 항상 불리하다는 의미는 아니다. 실험에서 검증한 것은 무작위 직교 회전에 대한 학습 알고리즘의 반응이다.
7. Discussion
이 논문은 Tree-based model의 우수성을 세 가지 Inductive bias와 연결하여 설명한다.
FindingTree-based model의 특성Neural Network의 특성
| Irregular target function | 급격한 변화와 threshold를 쉽게 표현 | 상대적으로 smooth한 함수 학습을 선호 |
| Uninformative features | 유용한 feature 중심으로 분할 가능 | MLP 계열은 불필요한 feature에 더 민감 |
| Feature orientation | 원래 feature 축을 활용 | 일반적인 MLP는 회전에 상대적으로 불변 |
이 세 가지 특성은 서로 독립적인 문제가 아니라 연결되어 있다.
Tree-based model은 각 feature를 기준으로 데이터를 분할하기 때문에 원래 feature orientation을 활용할 수 있고, 이러한 구조는 불필요한 feature를 무시하거나 불규칙한 함수를 표현하는 데도 도움이 될 수 있다.
반면 일반적인 Neural Network는 유연한 함수 근사 능력을 가지지만, Tabular data에 적합한 구조를 데이터로부터 학습해야 하는 부담이 있다.
Limitations
이 연구의 결과를 해석할 때는 몇 가지 제한점을 고려해야 한다.
첫째, 중간 규모의 Tabular data를 중심으로 분석했다.
주요 실험에서는 최대 10,000개의 training sample과 500개 미만의 feature를 사용했다. 따라서 매우 큰 데이터셋이나 수만 개의 feature를 가진 고차원 데이터에 결과를 그대로 일반화하기 어렵다.
둘째, Inductive bias 분석은 numerical feature 기반 binary classification에 집중되어 있다.
Multiclass classification이나 missing value가 존재하는 데이터에서는 다른 결과가 나타날 수 있다.
셋째, Deep learning의 representation learning 능력을 직접 평가하지 않았다.
Tree-based model보다 최종 예측 성능이 낮더라도 Neural Network가 학습한 embedding이 다른 downstream task에서 유용할 가능성은 남아 있다.
넷째, 제시된 세 가지 요인이 전체 성능 차이를 완전히 설명하는 것은 아니다.
이 연구는 데이터 변형 실험을 통해 유력한 설명을 제시했지만, 모든 Tabular learning 문제에서 동일한 메커니즘이 작동한다는 것을 증명하지는 않았다.
8. Conclusion
이 논문의 중요한 기여는 단순히 Tree-based model이 Neural Network보다 좋은 성능을 보인다는 것을 재확인한 데 있지 않다.
그보다 왜 특정 데이터에서 어떤 모델이 더 잘 작동하는지, 모델의 Inductive bias와 데이터 특성을 연결해 실험적으로 분석했다는 점이 핵심이다.
저자들은 Tabular data에 적합한 Neural Network를 설계할 때 다음 세 가지를 고려해야 한다고 제안한다.
- Uninformative feature에 대한 강건성
- 원래 feature orientation을 활용하는 구조
- Irregular target function을 효과적으로 학습하는 능력
결국 모델의 복잡도나 표현력만으로 실제 성능을 설명하기는 어렵다.
데이터가 어떤 구조를 가지고 있으며, 모델이 어떤 패턴을 더 쉽게 학습하도록 설계되어 있는지가 중요하다.