[2026-2] 이루가 - Gradient Boosting Trees and Large LanguageModels for Tabular Data Few-Shot Learning
논문링크: https://arxiv.org/abs/2411.04324
Gradient Boosting Trees and Large Language Models for Tabular Data Few-Shot Learning
Large Language Models (LLM) have brought numerous of new applications to Machine Learning (ML). In the context of tabular data (TD), recent studies show that TabLLM is a very powerful mechanism for few-shot-learning (FSL) applications, even if gradient boo
arxiv.org
Abstract
1. 연구 배경 (Background)
-
Tabular Data에서의 GBDT
-
전통적으로 정형 데이터(Tabular Data) 분야에서 우수한 성능을 보여온 모델
-
-
LLM 기반 Few-Shot Learning(FSL)의 등장
-
최근 연구에서 TabLLM이 적은 학습 데이터만으로도 높은 예측 성능을 달성할 수 있음을 확인
-
기존 GBDT 대비 LLM의 경쟁력 확인
-
-
기존 연구의 한계
-
LLM과 비교하는 GBDT Baseline의 성능 개선 여지가 존재
-
2. 연구 목적 및 방법 (Methodology)
- 기존 Benchmark 재현 및 LightGBM 개선
-
공개 Benchmark 실험 재현
-
소수의 샘플에서도 트리 노드 분할(Node Splitting)이 발생하도록 설정
-
Few-shot 환경에서 GBDT 학습을 위한 핵심 요소로 Node Splitting에 주목
-
기존 Baseline 대비 LightGBM 성능 290% 개선
3. 주요 실험 결과 (Results)
-
TabLLM vs. GBDT
-
8-shot 이하: TabLLM이 GBDT보다 우수한 성능
-
학습 샘플 수 증가 시: GBDT가 경쟁력 있는 성능 달성
-
GBDT는 TabLLM 대비 훨씬 적은 실행 시간(Runtime) 필요
-
-
실제 대규모 데이터 환경에서 FSL 활용
-
충분한 학습 데이터가 존재하더라도 FSL을 통해 모델 다양성(Model Diversity) 향상 가능
-
ExtraTrees와 FSL을 결합하여 과적합(Overfitting)에 대한 강건성 확보
-
ML Competition에서 제안 방법론을 검증하여 1위 달성
-
I. Introduction
1. 연구 배경 (Background)
-
Deep Learning(DL)의 발전
-
NLP 분야에서 Transformer, DeBERTa 등 대규모 사전 학습 모델을 통한 SOTA 성능 달성
-
CV 분야에서도 CNN, EfficientNet, ViT 등의 발전을 통한 성능 개선
-
그러나 Tabular Data에서는 GBDT를 일관되게 능가하는 DL 기반 모델이 부재
-
-
Tabular Data에서 GBDT의 강점
-
정형 데이터는 다양한 실제 산업 및 연구 분야에서 가장 보편적으로 사용되는 데이터 형태
-
Wide&Deep, DeepFM, TabNet, TabTransformer, SAINT 등 다양한 DL 기반 모델의 등장
-
특정 데이터셋이나 환경에서는 DL이 우수하지만, 다양한 조건에서 GBDT를 지속적으로 능가한다는 근거는 부족
-
2. LLM의 등장과 Few-Shot Learning
-
LLM의 발전
-
NLP, 코드 생성 등 다양한 작업에서 높은 성능 달성
-
Representation Learning, Sequential Processing, Generalization 측면에서 GBDT 대비 잠재적 이점 보유
-
이러한 특성을 바탕으로 LLM을 Tabular Data에 적용하려는 연구 증가
-
-
Few-Shot Learning(FSL)에서의 LLM의 강점
-
학습 데이터가 제한적인 환경에서는 LLM 기반 접근법이 유리할 가능성
-
Zero-Shot Learning(ZSL): 별도의 학습 예시 없이 새로운 작업 수행
-
Few-Shot Learning(FSL): 소수의 학습 예시만 활용하여 새로운 작업 수행
-
GBDT는 Zero-Shot 환경에서 무작위 예측 수준의 성능을 보일 것으로 예상
-
기존 연구에서 Few-Shot 환경의 LLM이 XGBoost보다 우수한 성능을 보인 사례 확인
-
3. 기존 연구의 한계 (Research Gap)
-
DL과 GBDT의 성능 비교에 대한 문제
-
기존 연구에서 DL이 GBDT보다 우수하다는 주장이 특정 데이터셋이나 실험 환경에 한정되는 경우 존재
-
실험 설정에 따른 편향(Bias)으로 인해 GBDT 성능이 과소평가되었을 가능성
-
-
Few-Shot 환경에서의 비교 검증 필요성
-
기존 연구는 LLM이 Few-Shot 환경에서 GBDT보다 우수하다는 결과 제시
-
그러나 GBDT Baseline이 충분히 최적화되었는지에 대한 추가 검증 필요
-
4. 연구 목적 (Research Objective)
-
Few-Shot 환경에서 GBDT 성능 재평가
-
Few-Shot Learning 설정에서 GBDT의 성능을 심층적으로 분석
-
기존 실험을 개선하여 보다 강력한 GBDT Baseline 구축
-
-
LLM과 GBDT의 공정한 성능 비교
-
기존 연구에서 제시된 LLM의 우수성이 적절한 GBDT Baseline에서도 유지되는지 검증
-
Few-Shot 환경에서 LLM이 GBDT보다 우수하다는 기존 결론의 타당성 재검토
-
II. Related Work
1. Zero-Shot / Few-Shot Learning의 평가 문제
-
ZSL 및 FSL의 정의
-
Zero-Shot Learning (ZSL): 학습 과정에서 해당 데이터 샘플을 전혀 보지 않은 상태에서 예측 수행
-
Few-Shot Learning (FSL): 소수의 데이터 샘플만 활용하여 학습 및 예측 수행
-
-
사전 학습된 LLM의 Data Contamination 문제
-
사전 학습 과정에서 평가 데이터셋을 이미 접했을 가능성 존재
-
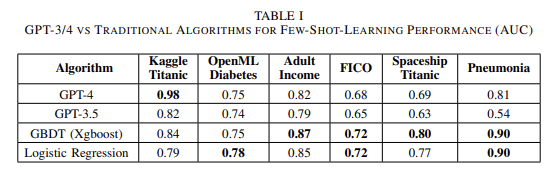
GPT-3.5, GPT-4가 Adult Income, FICO 등 공개 데이터셋을 학습 과정에서 접했다는 연구 결과 존재
-
일부 데이터셋에서는 **LLM이 실제 데이터 샘플을 그대로 암기(Memorization)**한 사례 확인
-
GBDT는 평가 데이터에 대한 사전 노출 여부를 통제할 수 있지만, LLM은 이를 보장하기 어려움
-
따라서 LLM과 GBDT의 공정한 Few-Shot 성능 비교에 어려움 존재
-
2. 기존 연구: LLM의 Memorization 문제 (Bordt et al.)
-
20-Shot Learning 환경에서 LLM과 GBDT 비교
-
GPT-3.5 및 GPT-4의 데이터 암기 여부와 예측 성능 분석
-
LLM도 일정 수준의 예측 성능을 달성하지만, GBDT 대비 성능 격차 존재
-
GBDT는 상대적으로 단순한 구조와 빠른 실행 속도를 바탕으로 높은 효율성 확보
-
- Memorization에 의한 성능 과대평가
-
Kaggle Titanic 데이터셋에서 GPT-4의 높은 성능이 실제 학습 능력보다는 데이터 암기에 기인한 것으로 확인
-
Tabular Data 외 다른 도메인에서도 유사한 현상 관찰
-
다만 암기되지 않은 데이터셋에서도 LLM의 일정 수준의 학습 능력 확인
- 특히 극소량의 학습 데이터가 주어지는 환경에서 LLM의 활용 가능성 존재
-
3. 기존 연구: TabLLM (Hegselmann et al.)
-
TabLLM의 핵심 아이디어
-
LLM을 활용한 Tabular Data의 Few-Shot Classification 방법 제안
-
Serialization을 통해 정형 데이터를 자연어 형태로 변환한 뒤 LLM에 입력
-
다양한 Serialization 기법을 비교한 결과, 단순한 Text Template 방식도 효과적인 성능 달성
-
-
Text Template 방식
-
각 Feature를 "The <column name> is <value>" 형태의 자연어 문장으로 변환
-
변환된 데이터에 Task-specific Prompt를 추가
-
이후 Few-Shot 환경에 맞춰 Fine-tuning 수행
-
-
실험 설정
-
Binary Classification 및 Multiclass Classification 데이터셋에서 성능 평가
-
본 논문에서는 동일한 평가 목적과 지표를 유지하기 위해 Binary Classification에 집중
-
주요 평가 지표로 AUC 활용
-
4. 기존 Few-Shot Benchmark 결과
-
TabLLM 및 TabPFN의 우수한 성능
-
기존 실험에서 NN 기반 모델인 TabLLM과 TabPFN이 LightGBM보다 높은 Few-Shot 성능 달성
-
4~64-Shot 범위에서 TabLLM과 LightGBM 간 큰 성능 격차 관찰
-
-
데이터셋별 성능 차이
-
Bank Dataset
-
TabLLM AUC: 0.642
-
LightGBM AUC: 0.554
-
무작위 예측 수준(AUC 0.5)을 기준으로 계산 시 163%의 상대 성능
-
-
Credit-g Dataset
-
TabLLM AUC: 0.686
-
LightGBM AUC: 0.522
-
동일한 계산 방식으로 745%의 상대 성능
-
-
위 수치는 단순 AUC 비율이 아니라 AUC 0.5를 초과하는 성능을 기준으로 계산한 비율
-
-
기존 Benchmark의 문제점
-
LightGBM의 성능이 극단적으로 낮게 측정된 사례 존재
-
Few-Shot 환경에 적합하지 않은 LightGBM 설정이 성능 격차의 원인일 가능성
-
LightGBM의 Baseline 설정을 재검토할 필요성 제기
-

5. 본 연구와의 연결
-
기존 연구의 핵심 한계
-
LLM의 사전 학습 데이터 노출에 따른 공정성 문제
-
Few-Shot 환경에서 LightGBM의 낮은 성능과 부적절한 Baseline 설정 가능성
-
-
본 연구의 접근 방향
-
기존 TabLLM Benchmark에서 나타난 LightGBM의 성능 저하 원인 분석
-
Few-Shot 환경에 적합한 LightGBM 설정 제안
-
강력하고 공정한 GBDT Baseline 구축을 통한 기존 연구 결과 재검증
-
III. Proposed Solution
1. Few-Shot Learning에서 LightGBM의 문제점
-
Few-Shot Learning(FSL)의 특성
-
소수의 학습 샘플만을 활용하여 모델을 학습하는 방식
-
FSL 환경에 적합한 모델 구축을 위해 LightGBM의 학습 메커니즘에 대한 이해 필요
-
-
LightGBM의 학습 방식
-
Decision Tree를 기반으로 Gradient Boosting 수행
-
Loss Function의 Negative Gradient를 학습하도록 트리 구성
-
각 노드에서 Information Gain을 최대화하는 Feature와 Split Point 선택
-
Split 과정에서 각 Leaf Node에 포함되는 최소 샘플 수에 대한 제약 존재
-
2. 핵심 문제: Minimum Samples per Leaf
-
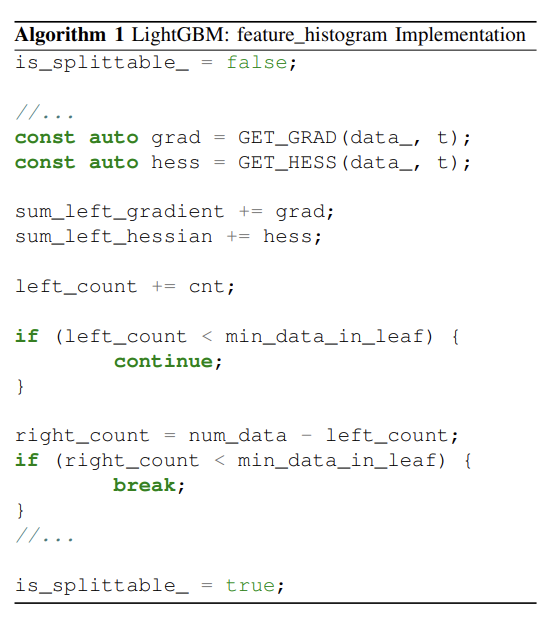
min_data_in_leaf 파라미터
-
하나의 Leaf Node에 포함되어야 하는 최소 데이터 수를 제어하는 파라미터
-
LightGBM의 기본 설정값은 20
-
노드를 분할하려면 양쪽 자식 노드가 최소 샘플 수 조건을 충족해야 함
-
-
Few-Shot 환경에서의 문제
-
학습 데이터가 극히 적은 경우 최소 샘플 수 조건을 충족하기 어려움
-
조건을 만족하지 못하면 Node Splitting이 발생하지 않아 트리 학습이 사실상 중단
-
결과적으로 기존 Benchmark에서 LightGBM이 무작위 예측 수준인 AUC ≈ 0.5를 기록하는 주요 원인
-
-
기존 연구의 한계
-
기존 연구에서도 하이퍼파라미터 튜닝을 수행했으나 최소 Leaf 샘플 수 문제를 해결하지 못함
-
Few-Shot 환경에 적합하지 않은 기본 설정으로 인해 LightGBM의 성능이 과소평가되었을 가능성
-
3. 제안 방법: Few-Shot에 특화된 LightGBM 설정
-
min_data_in_leaf 제약 완화
-
FSL 환경에서 가장 중요한 하이퍼파라미터
-
소수의 샘플에서도 Node Splitting이 가능하도록 최소 Leaf 샘플 수 축소
-
이를 통해 트리 학습이 정상적으로 진행될 수 있도록 개선
-
-
샘플 수 기반 제약 조건 최소화
-
min_data_per_group 등 샘플 수에 따라 분할이나 그룹화를 제한하는 파라미터 조정
-
극소량의 데이터에서도 학습이 가능하도록 제약 완화
-
-
주의 사항
-
이러한 설정은 FSL 환경에 특화된 접근 방식
-
일반적인 데이터 규모에서는 제약 완화로 인해 과적합(Overfitting) 위험 증가
-
따라서 Non-FSL 환경에서는 신중한 적용 필요
-
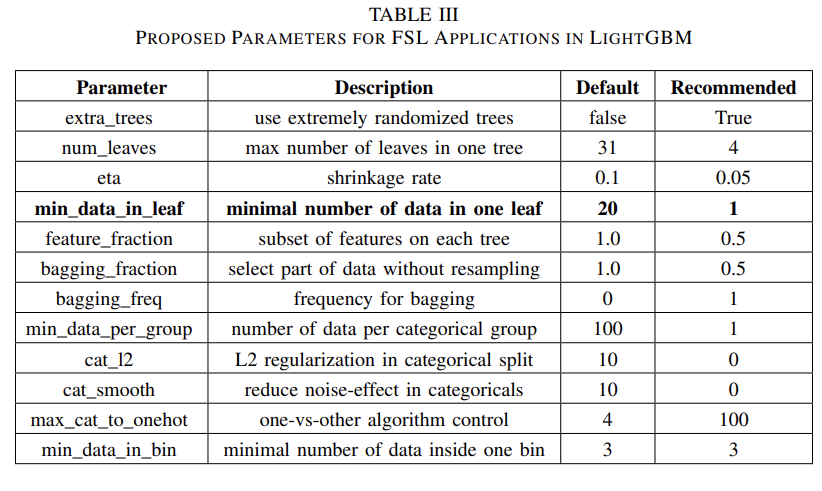
4. Extremely Randomized Trees 활용
-
기존 Decision Tree 분할의 한계
-
적은 학습 샘플로 인해 Feature Histogram 및 분할 후보가 제한됨
-
최적의 분할 지점을 탐색하는 Greedy 방식이 Few-Shot 환경에서 불리하게 작용할 가능성
-
-
Extremely Randomized Trees 적용
-
분할 지점 선택에 무작위성을 도입하여 제한적인 데이터에서도 다양한 Partition 생성 유도
-
특정 분할 기준에 지나치게 의존하는 문제 완화
-
트리 구조 내 분할의 다양성을 확보하여 Few-Shot 학습 성능 개선 시도
-
5. 핵심 요약
-
기존 LightGBM의 Few-Shot 성능 저하는 모델 자체의 한계보다는 최소 샘플 수에 대한 제약 조건에서 비롯될 가능성
-
min_data_in_leaf 감소를 통해 소수의 학습 데이터에서도 Node Splitting 활성화
-
샘플 수 기반 제약 완화 및 Extremely Randomized Trees 활용을 통해 Few-Shot 환경에 적합한 학습 구조 구성
-
다만 해당 설정은 과적합 위험이 존재하므로 일반적인 학습 환경과 구분하여 적용할 필요성
IV. Experiments
1. 실험 개요 (Experimental Setup)
-
실험 목적
-
Few-Shot 환경에서 제안한 LightGBM 설정의 성능 검증
-
대규모 데이터 환경에서도 FSL을 활용한 성능 개선 가능성 확인
-
-
실험 구성
-
Experiment A: TabLLM Benchmark 재현
-
기존 연구의 실험을 재현하고 제안한 LightGBM 설정 적용
-
TabLLM, TabPFN과의 성능 비교
-
-
Experiment B: FedCSIS 2024 Data Science Challenge
-
실제 주식 투자 전략 예측 문제에 FSL 적용
-
Sample Selection 및 Ensemble 기법을 통한 모델 다양성 및 일반화 성능 개선
-
-
2. Experiment A: TabLLM Experiment Replication
2.1. 기존 Benchmark의 문제점
-
기존 연구 결과
-
TabPFN과 TabLLM은 평균적으로 유사한 성능을 보이며, TabPFN이 약 1% 우세
-
두 모델 모두 기존 LightGBM 대비 평균 343%의 상대 성능 기록
-
Credit-g 데이터셋에서는 TabLLM이 LightGBM 대비 745%의 상대 성능 기록
-
-
기존 LightGBM의 성능 저하 원인
-
기존 Benchmark 결과 자체는 재현 가능
-
다만 LightGBM의 극단적으로 낮은 성능은 부적절한 하이퍼파라미터 설정에 기인
-
Few-Shot 환경에서 Node Splitting을 제한하는 설정이 핵심 문제
-
2.2. 제안 방법 적용
-
LightGBM 실험 설정
-
기존 연구의 Binary Classification 데이터셋 재현
-
Section III에서 제안한 FSL 전용 하이퍼파라미터 적용
-
별도의 Hyperparameter Tuning 없이 고정된 파라미터 사용
-
튜닝 효과를 배제하고 제안 설정 자체의 효과를 검증하기 위한 실험 설계
-
-
주요 결과
-
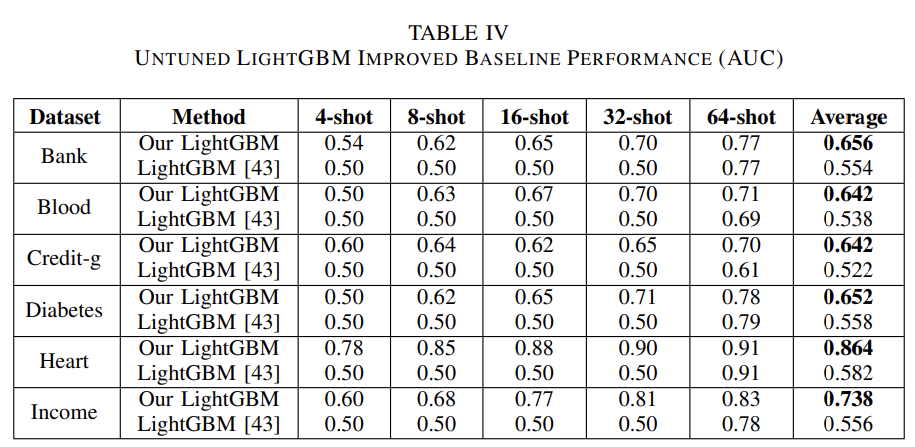
기존 LightGBM 대비 290% 성능 개선
-
TabLLM 및 TabPFN의 기존 성능 우위를 84.5% 감소
-
기존 Benchmark에서 과소평가된 GBDT의 경쟁력 확인
-
2.3. Shot 수에 따른 성능 비교
-
4~8 Shot
-
LightGBM의 성능이 개선되었지만 전반적으로 TabLLM보다 낮은 성능
-
추가 하이퍼파라미터 튜닝을 통한 개선 가능성 존재
-
다만 여전히 상당한 성능 격차 존재
-
-
16 Shot 이상
-
LightGBM과 LLM 기반 모델 간 성능 격차 감소
-
Shot 수가 증가할수록 LightGBM의 경쟁력 강화
-
-
64 Shot
-
6개 데이터셋 중 5개에서 LightGBM이 TabLLM과 동등하거나 우수한 성능 달성
-
Income 데이터셋에서만 TabLLM의 우위 유지
-
Income 데이터셋의 TabLLM 성능이 Shot 수와 관계없이 일정하게 유지되는 현상 관찰
-
해당 현상에 대해 Memorization 가능성에 대한 추가 검토 필요성 제기
-
-
실행 효율성
-
학습 데이터가 충분해질수록 TabLLM 및 TabPFN의 성능상 이점 감소
-
LightGBM이 훨씬 적은 실행 시간으로 경쟁력 있는 성능 달성
-
3. Experiment B: FedCSIS 2024 Data Science Challenge
3.1. Competition 개요
-
대회 목적
-
주식의 재무 지표를 기반으로 최적의 투자 전략 예측
-
예측 대상: Buy / Hold / Sell 중 하나의 행동
-
-
데이터 구성
-
총 116개 재무 Feature 제공
-
Static Features (I1~I58)
-
현재 Trailing Twelve Months(TTM) 기준 재무 지표
-
Dividend Payout Ratio, Gross Profit Margin 등
-
-
Relative Features (dI1~dI58)
-
각 재무 지표의 전년 대비 상대적 변화량
-
총 58개 Feature
-
-
3.2. Initial Model: Baseline 구축
-
초기 모델 설정
-
Feature Engineering 없이 모든 Feature를 그대로 사용
-
LightGBM Regression 모델 적용
-
이산형 Target인 Class(Buy / Hold / Sell)를 예측
-
-
Baseline 성능
-
MAE: 0.8439
-
-
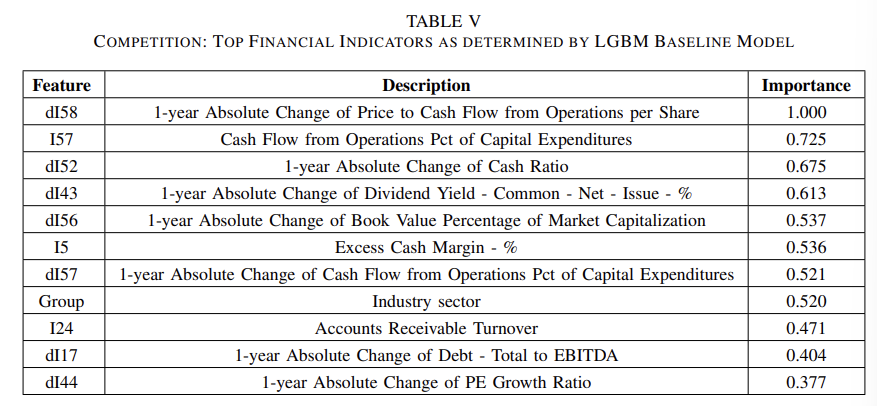
Feature Importance 분석
-
중요도 상위 5개 Feature 중 4개가 Relative Features(dI*)
-
Static Features보다 재무 지표의 변화량이 예측에 더 중요한 역할 수행
-
Feature Selection을 통한 일반화 성능 개선 가능성 확인
-
3.3. Sample and Feature Selection
- Feature Selection
-
Occam's Razor 원칙에 따라 불필요한 Feature 제거 검토
-
전체 Feature와 Relative Features만 사용한 모델 비교
| 전체 Feature (I* + dI*) | 0.6018 | 116개 Feature |
| Relative Features (dI*) | 0.5963 | 58개 Feature |
- 주요 결과
-
Feature 수를 50% 줄이면서도 기존 예측력의 약 95% 유지(논문 기준)
-
Feature 구성을 달리하여 서로 다른 Decision Boundary를 형성하는 모델 구축 가능
-
Ensemble 과정에서 모델 간 다양성 확보에 활용
-
Sample Selection
-
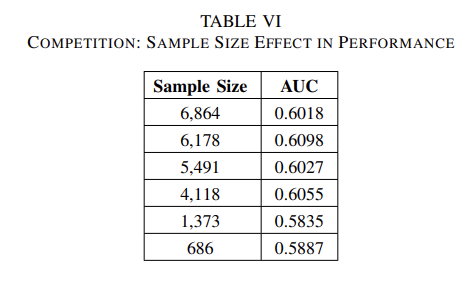
학습 샘플 수를 점진적으로 줄이면서 예측 성능 변화 분석
-
전체 6,864개 → 4,118개로 약 40% 감소시켜도 성능 저하가 관찰되지 않음
-
샘플 수를 추가로 줄여도 성능 감소는 제한적
-
-
핵심 Insight
-
전체 데이터를 사용하지 않아도 유사한 예측 성능 유지 가능
-
서로 겹치지 않는 학습 샘플로 여러 모델을 생성하여 Ensemble 다양성 확보 가능
-
Few-Shot 방식의 Sample Selection을 Stacking에 적용할 근거 확보
-
4. Stacking 기반 Ensemble
4.1. Level-0 Models: Base Model 구축
-
핵심 아이디어
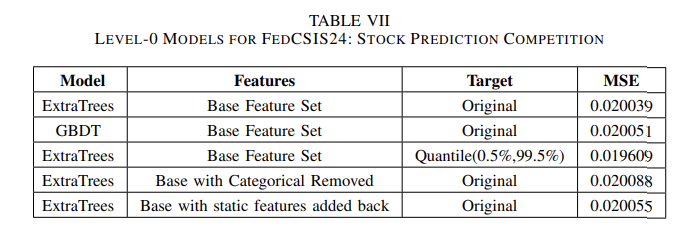
-
FSL을 활용하여 서로 다른 데이터로 학습된 다수의 Base Model 구축
-
Feature 및 Sample 구성을 다양화하여 모델 간 상관관계 감소 유도
-
-
Target 변경
-
기존: Class (Buy / Hold / Sell)
-
변경: Perform (연속형 투자 성과)
-
동일한 Buy 예측이라도 실제 수익률은 다를 수 있으므로 연속형 Target이 더 풍부한 정보 제공
-
Target 변경에 따라 평가 지표를 MAE → MSE로 전환
-
-
Base Model 학습 설정
-
각 모델에 약 3,000개 학습 샘플(3k-shot) 사용
-
서로 다른 Sample 구성을 통한 모델 다양성 확보
-
FSL 환경에서 강점을 보인 ExtraTrees 활용
-
별도의 새로운 Feature Engineering 없이 기존 재무 지표 활용
-
Relative Features(dI*)만 사용하고, 동일 종목의 여러 연도 데이터를 결합하여 Feature Set 구성
-
4.2. Level-1 Model: Meta Model 구축
- Stacking 구조
-
서로 다른 설정으로 학습한 5개의 Level-0 모델 사용
-
각 Base Model의 예측 결과를 Level-1 Meta Model의 입력으로 활용
-
Meta Model을 통해 여러 예측 결과를 통합
- Meta Model 설정
| Model | MLPRegressor |
| Hidden Layers | 2개 |
| Neurons | 10, 5 |
| Activation | ReLU |
| Optimizer | Adam |
| Target | Perform |
| Validation Split | 10% |
| Early Stopping 기준 | R² Score |
| Max Epochs | 64 |
- 최종 예측 변환
-
Meta Model이 연속형 투자 성과(Perform) 예측
-
대회 제출을 위해 연속형 예측값을 Buy / Hold / Sell로 변환
-
Train과 Test의 Action Distribution이 동일하도록 Threshold 최적화
5. Competition 결과
-
최종 성능
-
FedCSIS 2024 Data Science Challenge 1위 달성
-
최종 MAE: 0.772
-
2위 대비 3.66% 상대 개선
-
10위 대비 7.12% 상대 개선
-
-
주요 성과
-
FSL 기반 Sample Selection으로 모델 간 다양성 확보
-
ExtraTrees 및 Stacking을 활용한 일반화 성능 강화
-
대규모 데이터에서도 전체 샘플을 모두 사용하지 않는 학습 전략의 유용성 확인
-
6. 핵심 요약 (Key Takeaways)
-
Few-Shot Benchmark
-
LightGBM의 적절한 하이퍼파라미터 설정만으로 기존 대비 290% 성능 개선
-
8-shot 이하에서는 TabLLM이 우세하지만, 데이터 수 증가에 따라 LightGBM의 경쟁력 강화
-
64-shot에서는 대부분의 데이터셋에서 TabLLM과 동등하거나 우수한 성능 달성
-
-
실제 데이터 활용
-
Feature 및 Sample Selection을 통해 모델의 다양성 확보
-
FSL + ExtraTrees + Stacking을 활용한 효과적인 Ensemble 구성
-
FedCSIS 2024 대회에서 1위를 기록하며 제안 방법의 실용성 확인
-
V. Conclusions
1. Baseline 설정의 중요성
-
공정한 성능 비교를 위한 강력한 Baseline의 필요성
-
새로운 모델의 우수성은 비교 대상인 Baseline의 성능에 크게 의존
-
성능이 낮은 Baseline을 사용하면 새로운 모델의 성능이 과대평가될 가능성
-
새로운 모델 개발뿐 아니라 기존 Baseline을 최적화하는 과정 역시 중요
-
-
LightGBM 성능 개선
-
Few-Shot 환경에 적합한 파라미터 설정을 통해 기존 연구 대비 290% 성능 개선
-
단순한 파라미터 최적화만으로 이례적으로 큰 성능 향상 달성
-
알고리즘 자체의 한계와 부적절한 설정으로 인한 성능 저하를 구분할 필요성
-
2. Few-Shot Learning에서 GBDT의 가능성
-
소량의 데이터에서도 GBDT의 경쟁력 확인
-
최소 8-shot 수준의 데이터에서도 유의미한 예측 성능 달성 가능
-
적절한 파라미터 설정을 통해 기존에 과소평가되었던 GBDT의 Few-Shot 학습 능력 확인
-
-
Ensemble 및 Stacking에서의 FSL 활용
-
충분한 학습 데이터가 존재하더라도 FSL을 활용할 가치 존재
-
서로 다른 소규모 학습 샘플을 활용하여 모델 간 다양성(Model Diversity) 확보
-
Ensemble 및 Stacking 구조에서 개별 모델의 상관관계를 낮추는 전략으로 활용 가능
-
3. 알고리즘 이해의 중요성
-
알고리즘의 특성을 고려한 최적화
-
계산 비용으로 인해 Global Optimum을 탐색하는 것은 현실적으로 어려움
-
대신 알고리즘의 내부 동작 원리와 제약 조건을 이해하여 성능을 개선하는 접근 필요
-
-
실제 Competition에서의 검증
-
FSL 기반 Sample Selection을 통한 모델 다양성 확보
-
ExtraTrees를 활용한 Overfitting 완화
-
두 접근법을 결합하여 FedCSIS 2024 Data Science Challenge 1위 달성
-
4. 핵심 결론 (Key Takeaways)
-
Strong Baseline의 중요성: 새로운 모델과의 공정한 성능 비교를 위해 기존 모델에 대한 충분한 최적화 필요
-
GBDT의 Few-Shot Learning 가능성: 적절한 파라미터 설정만으로 극소량의 데이터에서도 경쟁력 있는 성능 확보 가능
-
FSL의 새로운 활용 방식: 단순히 데이터 부족 문제를 해결하는 것을 넘어 Ensemble의 모델 다양성 확보에도 활용 가능
-
알고리즘 이해 기반 최적화: 모델의 내부 동작 원리와 특성을 이해하는 것이 새로운 모델 개발만큼 중요할 수 있음을 확인